克雷西 发自 凹非寺足球直播app哪个好用
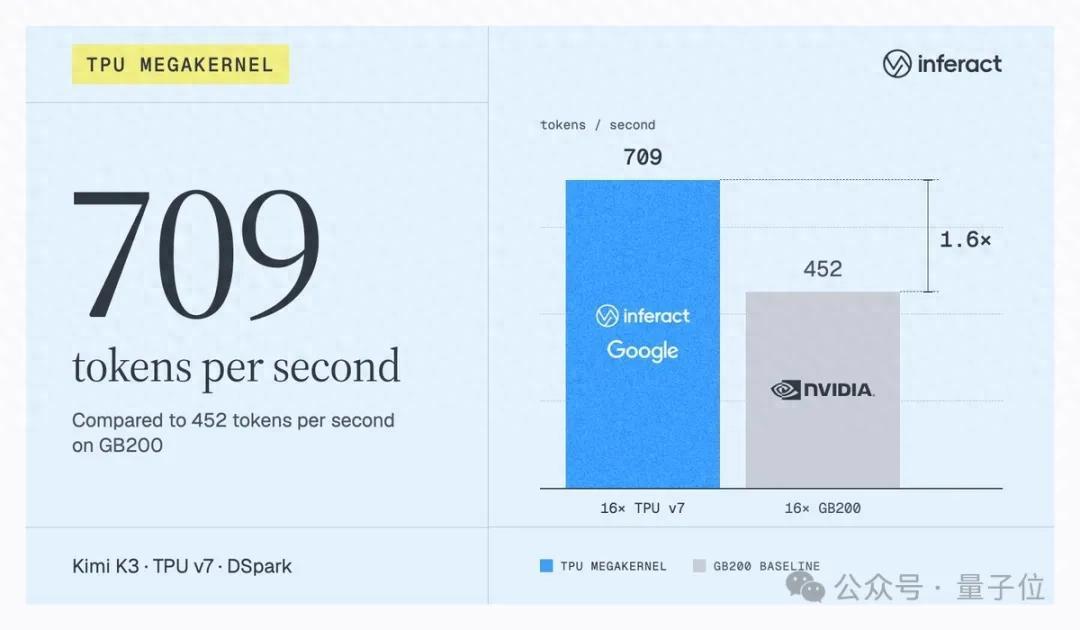
量子位 | 公众号QbitAI16块谷歌TPU v7跑Kimi K3,每秒跑出了709个Token,比老黄的GB200快了57%。
作念出这个收成的,既不是造Kimi的月之暗面,也不是造TPU的谷歌,是一家叫Inferact的推理创业公司。
Inferact首创团队即是vLLM的原班东谈主马,本年拿了a16z领投的1.5亿好意思元种子轮,估值8亿好意思元。
他们给TPU写了一种叫megakernel的推理内核,把模子推理时正本要调解的几百个小纪律焊成一个大纪律。
配合TPU私有的片上内存架构,megakernel把内存带宽欺诈率逼到了硬件表面峰值隔邻。
配上DeepSeek提议的DSpark加快框架,K3在TPU上跑出了前边提到的每秒709 token的收成。
这套代码,面前依然开源。
不异16块芯片,TPU快57%
Inferact把TPU和英伟达GPU放在彻底疏导的条目下跑了一轮benchmark,TPU赢了。
测试是用16块TPU v7 Ironwood对阵16块英伟达GB200,双方皆跑Kimi K3,皆用vLLM推理引擎,唯独的变量是芯片和底层的kernel完毕。
最终,TPU跑出的收成是每秒709个token,GB200跑出每秒452个,TPU的速率快了57%。
这个速率里有DSpark筹画解码的功劳。
DSpark是由DeepSeek提议的推理加快框架,其旨趣是让一个小模子先快速猜出一串候选token,然后大模子再对这串候选token作念批量考证,猜对的平直跳过,猜错的回退重来。
Inferact在TPU上跑通了这套经过,acceptance length达到了6,也即是每轮猜出的token里,平均有6个能平直通过大模子的考证,单步decode的耗时简短在8.5毫秒。
关掉筹画解码看裸速,差距不异拉得开。
在batch size为1的情况下,TPU每秒能跑249个token,GB200只须127个,差距接近一倍。
把batch size放大到8,TPU达到865个token每秒,GB200只须636个。
另外皮Qwen上,两种芯片的差距更大。
Inferact用4块TPU v7跑Qwen 3.8 27B,每秒跑出1515个token,不异设立的GB200只跑出了695个。
况且这种提速并莫得形成精度耗损,Inferact用greedy decoding作念了考证,Kimi K3在TPU上的GPQA-Diamond得分是94.4%,GSM8K是97.2%,和GPU上的收尾彻底一致。
推理引擎一样,模子一样,芯片换一下,速率就差出了57%。
这种进程的差距,按理说应该能从硬件规格表上找到诠释注解,但实质情况恰巧相背。
两款芯片的算力也在合并个量级,TPU v7的HBM带宽是7380 GB/s,而GB200的HBM带宽反而更高,达到8000 GB/s,带宽更大的那块芯片,跑出来的速率反而更低。
这种速率的差距,实质上起首于芯片上头跑的那层软件。
把几百个小kernel,焊成一个大纪律
Inferact用一个叫megakernel的决策科罚了TPU上的推理服从问题,中枢念念路,是把模子推理时正本要调解的几百个孤苦小纪律,合并成一个大纪律,从而舍弃纪律之间切换时的带宽骤然。
大模子推理的速率瓶颈不在野心,在数据搬运。
每生成一个token,模子的沿途权重皆要从HBM主存搬进芯片里面的高速缓存里算一遍,算完这一轮,下一个token再从新搬一遍。
传统的作念法是把一次推理拆成几百个孤苦的kernel,每个kernel精致一小块野心。
这些kernel排着队一个接一个地实际,但问题出依然会在顶住的症结。
上一个kernel干结束,下一个还莫得启动起来,这段时期里内存带宽就这样空转着。
CUDA Graphs和英伟达最新的PDL技能能谴责这个症结,但kernel之间的范畴还在。
Inferact的megakernel平直舍弃了这个范畴。
Kimi K3一共有92层MoE野心,Inferact把这92层的野心逻辑从新到尾塞进了一个Pallas纪律里,一次调用就走完系数这个词模子的前向传播。
范畴褪色之后,跨层权重预取就变得义正辞严了。
第N层还在算MoE的时候,第N+1层的attention权重依然初始从HBM往片上缓存搬了。
野心和数据搬运同期进行,内存带宽险些莫得空转的时刻。
TPU的硬件特质让这种编排作念起来相配顺畅。
TPU v7的每个TensorCore带有64 MiB的VMEM片上内存,这块内存的生命周期彻底交给软件来管束,工程师不错精准胁制什么时候往里面装什么数据、什么时候把空间腾出来。
64 MiB的容量实足同期装下刻下层的野心数据和下一层预取的权重。
GPU哪里情况不同,英伟达Blackwell架构的片上内存分辩在152个SM里面,总量简短38 MiB,由硬件自动调解,要作念雷同的跨层编排限度更多。
Inferact用Pallas言语手写了系数这个词megakernel的代码,Pallas是谷歌给TPU作念的底层编程言语,变装雷同英伟达GPU上的CUDA。
TPU默许的编译器用链XLA擅长优化单层野心,但跨92层调和数据搬运的决策分支太多,XLA的自动调解找不到最优解。
Inferact的作念法是绕过XLA,用Pallas言语手写系数这个词megakernel的代码,由工程师我方来决定每一步搬什么数据、存在哪块缓存、什么时候开释。
这样作念还带来了一个特殊平正,那即是编译速率大幅升迁,耗时从XLA的30分钟以上降到了不到90秒,工程师改完一版kernel一分半钟就能上机考证。
面前这套megakernel是针对Kimi K3的模子结构作念的定制优化,如若换一个模子架构还需要从新适配。
Inferact在博客里提到,团队接下来会把megakernel的援手膨胀到更多模子架构上。
vLLM原班东谈主马的创业公司
Inferact客岁11月建造,团队险些即是vLLM的原始开拓者,一群靠给英伟达GPU写推理引擎成名的东谈主。
他们本年一月出来创业,总结把TPU的推理速率作念到了GPU前边。
vLLM是面前开源推理引擎限制的分量级框架,援手进步500种模子架构,社区孝敬者进步2000东谈主,Meta、Google、Character.ai皆拿它来作念线上的推理处事。
CEO Simon Mo是vLLM技俩的原始保养者,伯克利EECS毕业,之前在Anyscale使命。
麇集首创东谈主Woosuk Kwon是系数这个词vLLM技俩的发起东谈主,伯克利野心计科学博士,导师是Ion Stoica。
Kwon提议的PagedAttention算法科罚了GPU显存管束中的碎屑化问题,这个算法于今仍然是vLLM的中枢技能。
首席科学家游凯超曾获清华大学零星奖学金,他在vLLM中主导了漫衍式推理功能的开拓。
Inferact本年完成了1.5亿好意思元的种子轮融资,公司估值8亿好意思元。a16z和Lightspeed领投,真格、红杉、Altimeter跟投。
此次的TPU megakernel来自Inferact与Google Cloud的一项麇集工程互助。
双方的指标是让TPU成为vLLM的一流援手对象,系数的优化服从皆会回馈给上游的开源社区,tpu-megakernels代码仓库是此次互助的第一个公开服从。
参考邻接:
https://inferact.ai/blog/tpu-megakernels— 完 —
量子位 QbitAI · 头条号签约暖和咱们,第一时期获知前沿科技动态下一篇:没有了